N 卡 AI 算力被锁一半?GPU-UNLOCK 解锁真相与 Windows 避坑指南
一句话版本:NVIDIA 确实把 GeForce 显卡上一部分张量核心运算(FP16/BF16 输入、FP32 累加,以及 TF32)限制在同芯片专业卡的一半速度,这在 NVIDIA 自己的架构白皮书里写得清清楚楚。开源项目 gpu-unlock 能在驱动加载前解除这个限制,矩阵乘法吞吐接近翻倍。但它不是「整张卡被锁了一半算力」,游戏、FP32、INT8 和量化模型基本不受影响。Windows 上也没有「一条命令一键解锁」:视频里那条命令实际只是兼容性检测脚本,项目说明写明它「不会解锁」。
11 月 3 日,YouTube 博主**「零度解说」(订阅约 115 万)发布视频《GPU 算力被破解!开源神器 GPU-UNLOCK,一键解锁显卡限制,本地 AI 速度提升 50% 以上!Windows/Linux 通用!》,同日在「零度博客」(freedidi.com)发了配套文章。视频说,国外开发者开源了一个项目,能把出厂「被人为锁了将近一半」的 N 卡算力解锁出来,跑本地 AI 生图、大模型都能明显提速。
我把视频提到的 GitHub 仓库、NVIDIA 官方白皮书和社区实测报告逐一翻了一遍。下文把博主的说法**、项目 README / 官方数据和社区实测分开写,查不到的直接标「未核实」。核实日期:2026 年 11 月 3 日。
⚠ 先说清楚:这类改动在系统启动前直接操作显卡寄存器,Windows 版还要求关闭安全启动(Secure Boot)和 BitLocker、改启动项。本文只做技术解读,仅供在自己的设备上学习和测试。动手前请务必完整备份数据、创建系统还原点、记下 BitLocker 恢复密钥。
一、这个项目到底是什么
视频里的「GPU-UNLOCK」其实是一组开源项目:
| 项目 | 平台 | 做什么 | 许可证 | 状态(2026-11-03) |
|---|---|---|---|---|
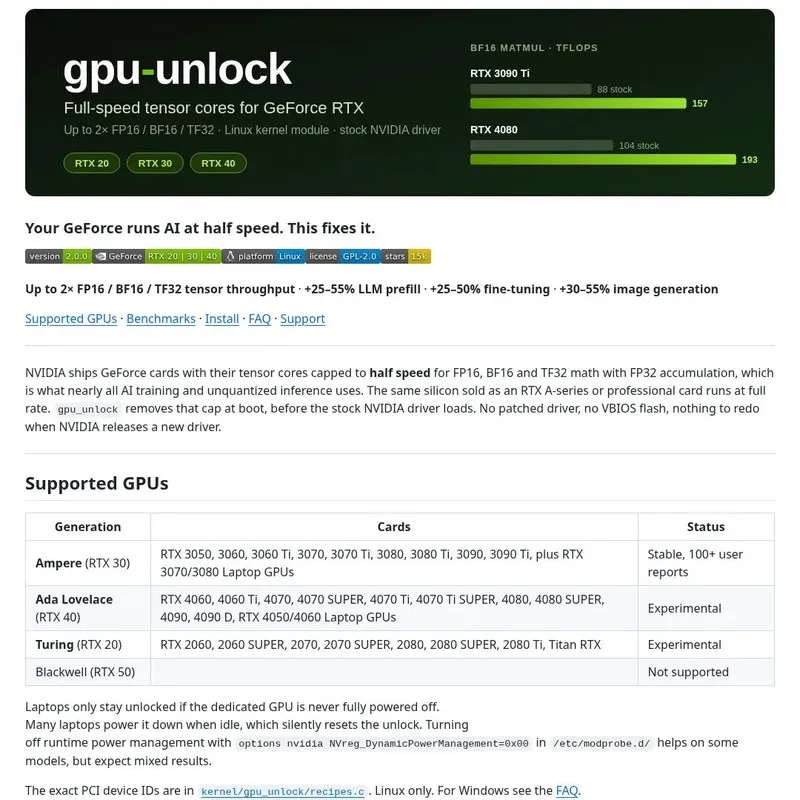
| Zagitta/gpu-unlock(主项目) | Linux | 内核模块,开机时在 NVIDIA 驱动接管显卡之前解除限制 | GPL-2.0 | 2026-10-18 创建,版本 2.0.0,约 1.5 万 Star |
| Windows-GPU-UNLOCK(作者 impacifist,现仓库地址为 windows-GPU-UNLOCK/Windows-GPU-UNLOCK,旧链接会自动跳转) | Windows | UEFI 启动程序,在 Windows 启动之前做同样的寄存器写入,再交给 GPU | GPL-2.0-only | 最新标签 v0.3.1,仅源码预发布,约 1.6k Star |
| 主项目作者 Zagitta 在 Hacker News 上说,核心利用手法并非他原创,他做的是把整个流程打包成「不需要给 NVIDIA 驱动打补丁」的形式,灵感来自矿卡(CMP 系列)在 Windows 上的 UEFI 解锁方案。Windows 移植版则基于 rough2515-hub/rtx3080-unlock-public 和 Zagitta/gpu-unlock。 | ||||
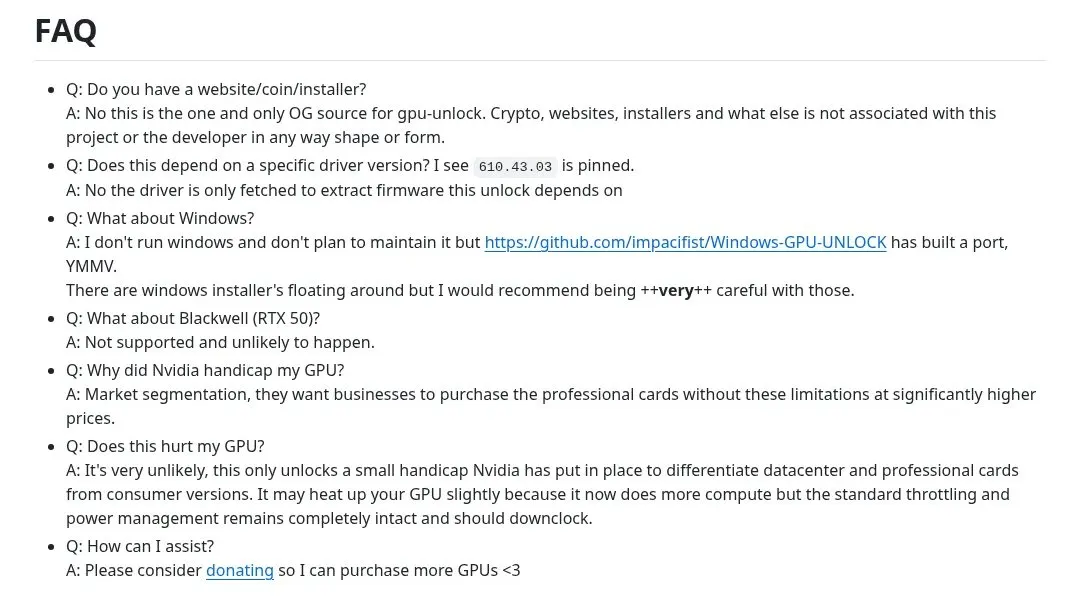
| 另外,社区里还有不少面向 40 系的分支(例如 JustAResearcher/gpu-unlock-ada、MarvinFS/rtx4090-uefi),也有人做了所谓的「一键安装器」。主项目作者在 FAQ 里明确说:他没有官网、没有代币、没有安装器,并提醒大家对流传的 Windows 安装器「要非常小心」。 | ||||
 |
||||
| 项目截图:Zagitta/gpu-unlock README 顶部与「Supported GPUs」表(github.com/Zagitta/gpu-unlock,2026-11-03 截取) | ||||
 |
||||
| 项目截图:README 的 FAQ。「What about Windows?」一条指向 impacifist 的移植版,并提醒对 Windows 安装器要非常小心;「Why did Nvidia handicap my GPU?」的回答是 Market segmentation(市场分级) |
二、原理:所谓「锁一半」锁的到底是什么
1. 先把几个精度格式讲清楚
· FP32(单精度):每个数用 32 位存储,精度高,传统 CUDA 计算和游戏着色器主要用它。
· FP16(半精度):16 位,占用小、算得快,但能表示的数值范围窄。
· BF16:同样是 16 位,数值范围和 FP32 一样大,只是小数位更少。现在大模型训练和推理很常用。
· TF32:NVIDIA 张量核心专用的格式,输入按 19 位有效位计算,用来加速原本用 FP32 写的矩阵运算。
AI 计算的大头是矩阵乘法,由显卡里的张量核心(Tensor Core)完成。一次矩阵乘法里有大量「先相乘、再累加」的操作:乘的时候可以用 FP16/BF16;加(累加)的时候,结果放在 FP16 还是 FP32 里,精度差别很大。累加的数一多,FP16 容易丢精度甚至溢出,所以 PyTorch 等主流框架做 FP16/BF16 矩阵乘法时,默认用 FP32 累加。
2. NVIDIA 白皮书里写着:GeForce 的 FP32 累加只有一半速度
我直接查了 NVIDIA 官方的 Ampere GA102 架构白皮书。同样是 GA102 芯片:
| 指标(峰值,不含稀疏) | GeForce RTX 3090 | 专业卡 RTX A6000 |
|---|---|---|
| FP16 张量,FP16 累加 | 142 TFLOPS | 154.8 TFLOPS |
| FP16 张量,FP32 累加 | 71 TFLOPS(只有上一行的一半) | 154.8 TFLOPS(不减半) |
| BF16 张量,FP32 累加 | 71 TFLOPS | 154.8 TFLOPS |
| TF32 张量 | 35.6 TFLOPS | 77.4 TFLOPS |
| INT8 张量 | 284 TOPS | 309.7 TOPS |
| FP32 非张量(CUDA 核心) | 35.6 TFLOPS | 38.7 TFLOPS |
| A6000 的 SM 数量(84 对 82)和频率略高,所以各项都略高一点。差距真正拉开的,是「FP32 累加」和 TF32 这几行:GeForce 恰好只有一半,而 INT8 和 FP32 CUDA 核心并没有被减半。40 系也一样:Ada 白皮书中 RTX 4090 的 FP16 张量(FP16 累加)是 330.3 TFLOPS,FP32 累加只有 165.2 TFLOPS。 | ||
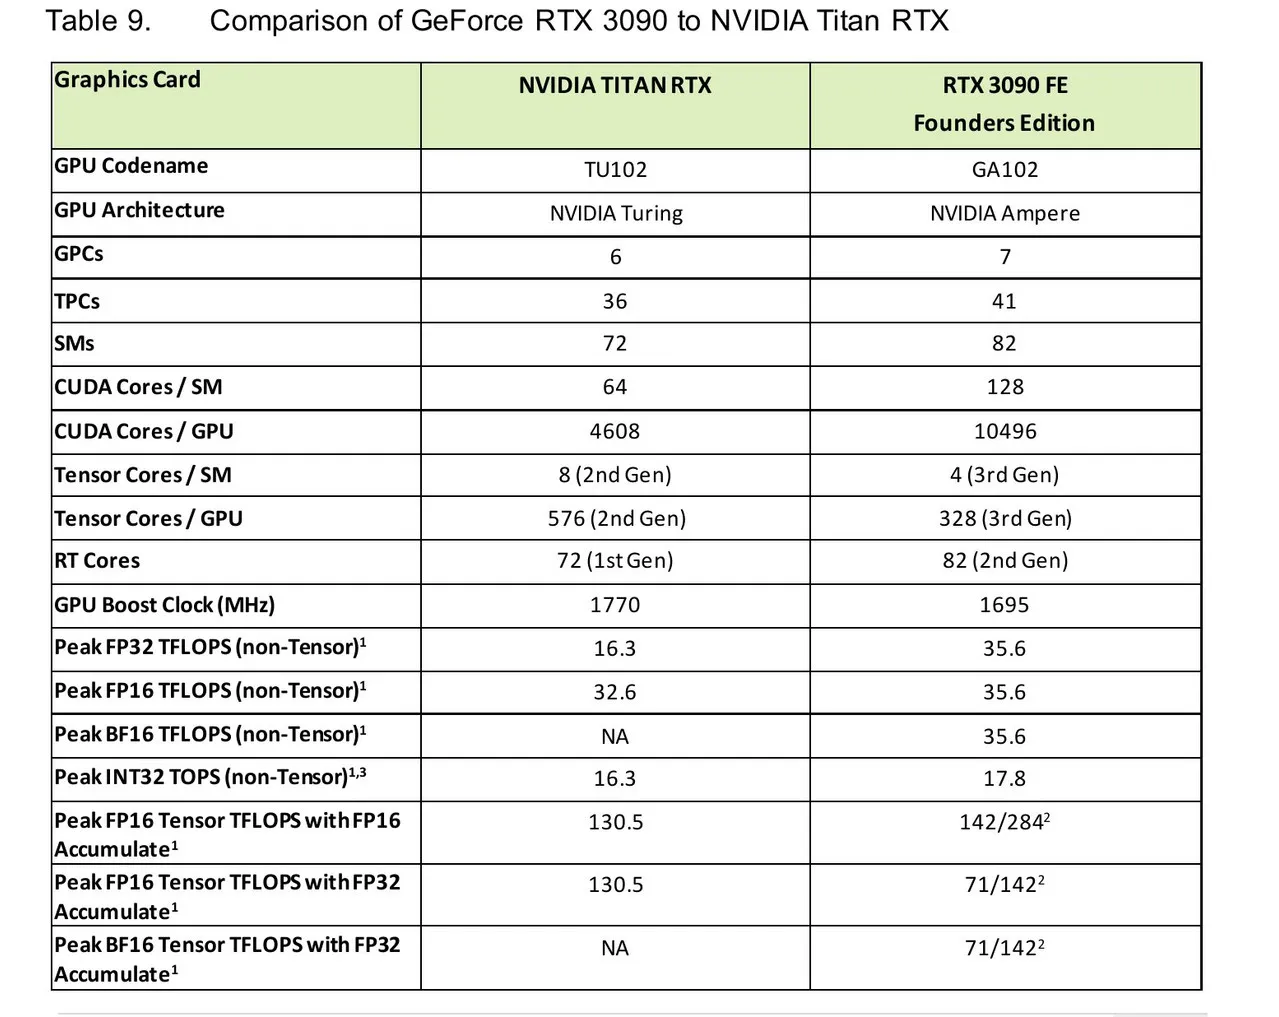 |
||
| 官方截图:NVIDIA Ampere GA102 白皮书 Table 9(第 44 页),RTX 3090 的「FP16 Tensor with FP32 Accumulate」为 71/142,只有 FP16 累加(142/284)的一半 | ||
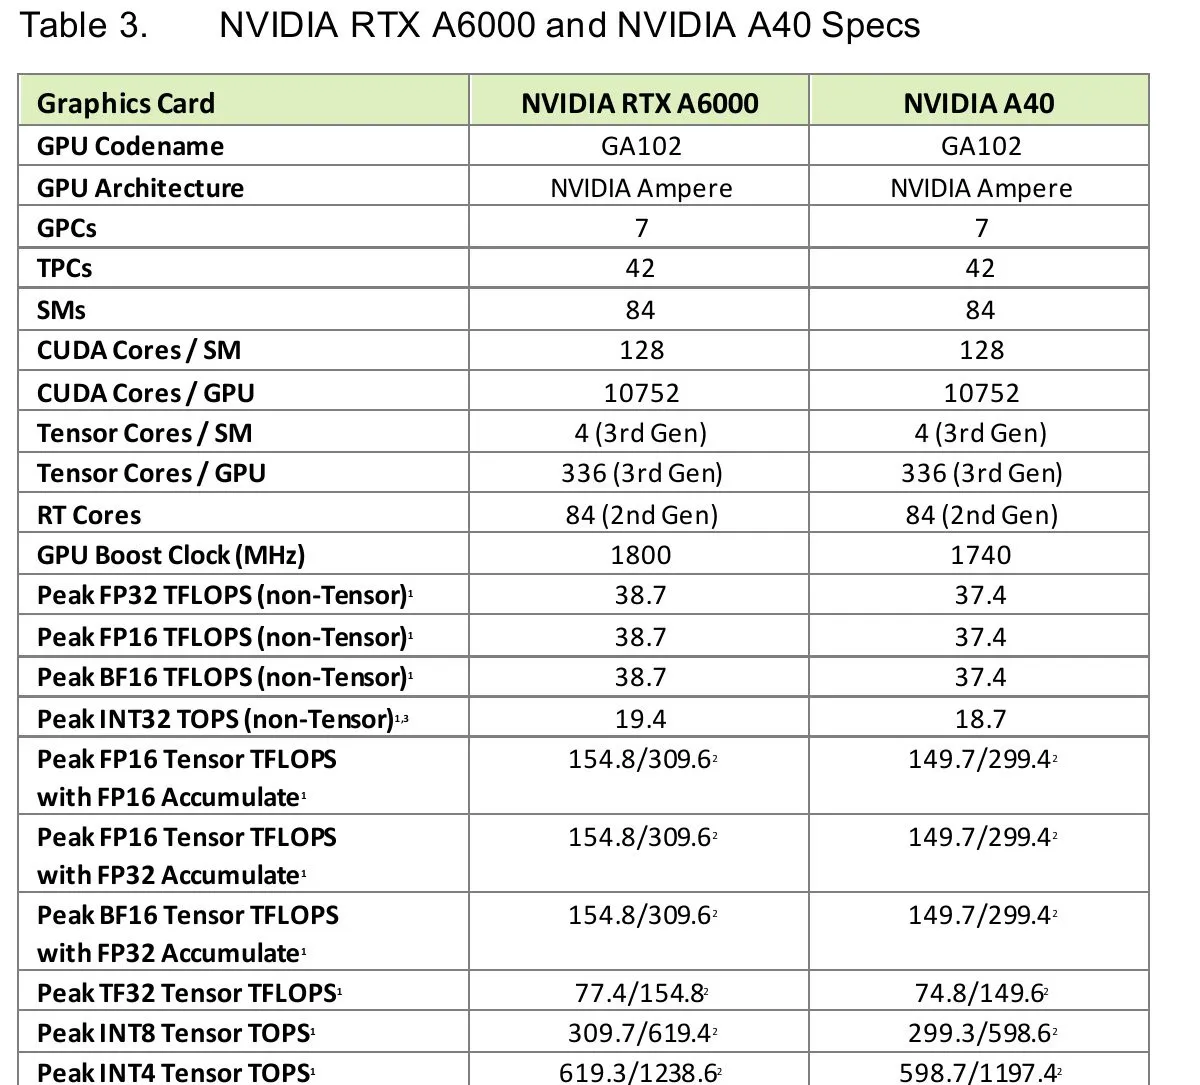 |
||
| 官方截图:同一份白皮书 Table 3(第 15 页),同为 GA102 的 RTX A6000,FP16 累加与 FP32 累加都是 154.8/309.6 | ||
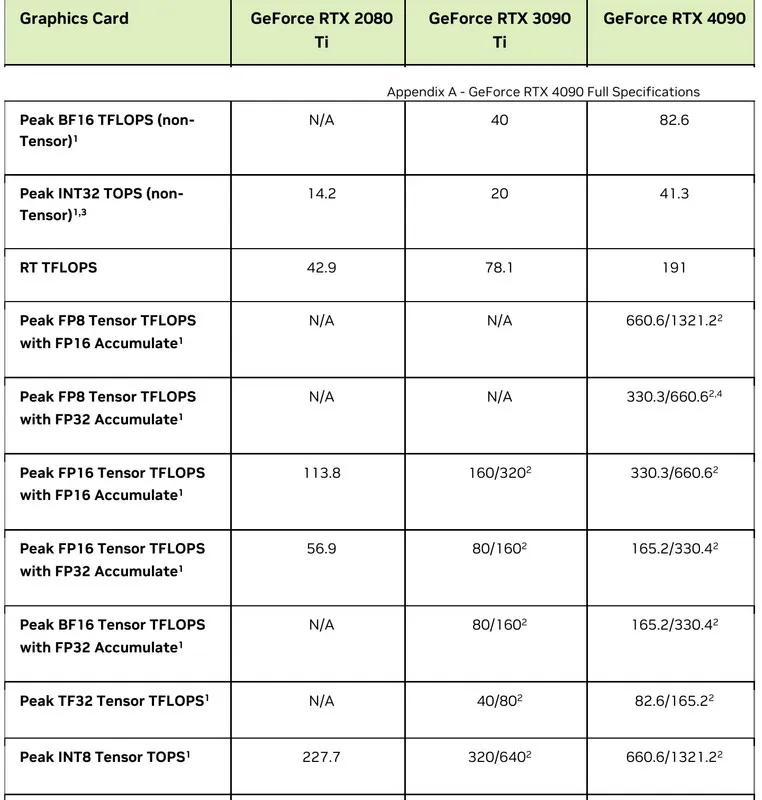 |
||
| 官方截图:NVIDIA Ada 架构白皮书附录 A,RTX 4090 的 FP16 累加 330.3、FP32 累加 165.2(表头取自第 29 页,数据取自第 30 页,二者拼接) | ||
| 结论: | ||
| · 「GeForce 上 FP16/BF16 用 FP32 累加时,张量吞吐只有 FP16 累加的一半」属实,而且 NVIDIA 公开写在白皮书里,并不是什么秘密。主项目 FAQ 给出的解释是市场分级:让需要这部分性能的企业去买更贵的专业卡。 |
· 「显卡出厂被人为锁了将近一半算力」夸大了。被限速的只是特定格式的张量核心矩阵运算。FP32 CUDA 计算、INT8 张量运算、游戏渲染都不在其中,「一半」不是整张卡的算力。
3. gpu-unlock 怎么解除限制
根据 README 的「How it works」:显卡内部有一组「速度选择」寄存器(SS0/SS1),决定这些指令按全速还是半速发射。gpu-unlock 借用矿卡解锁工具的 V67/PLM 方法,在 NVIDIA 驱动接管显卡之前,把 SS0 写成 0x88888888(选择全速 BF16)、SS1 写成 0x8,然后对显卡做一次功能级复位(FLR),再让未经修改的官方驱动正常加载。
所以它:
· 不改驱动,不刷显卡 BIOS。驱动更新后,Linux 版不需要重做;
· 必须在驱动之前运行。Linux 版做成随 initramfs 加载的内核模块,Windows 版做成 Windows 启动前运行的 UEFI 程序;
· 断电就失效。睡眠也会复位寄存器:Linux 版在唤醒时会自动重新解锁,但不支持休眠;笔记本独显空闲断电后,解锁也会悄悄失效。
· 它没有把累加改成 FP16,仍然是 FP32 累加,只是运行速度变快。README 写明解锁前后的计算结果「逐位一致」(bit-identical),所以不存在精度下降的问题。
三、真实提速有多少:官方数据、社区实测与博主说法
1. README 官方数据:矩阵乘法(BF16,FP32 累加,默认功耗)
| 显卡 | 解锁前 | 解锁后 | 提升 |
|---|---|---|---|
| RTX 3060 12GB | 27 TFLOPS | 51 TFLOPS | +87% |
| RTX 3060 Ti | 37 | 68 | +82% |
| RTX 3070 | 40 | 72 | +81% |
| RTX 3080 10GB | 65 | 113 | +73% |
| RTX 3090 | 75 | 125 | +65% |
| RTX 3090 Ti(450W) | 88 | 157 | +80% |
| RTX 4070 Ti | 81 | 150 | +84% |
| RTX 4080 | 104 | 193 | +87% |
| RTX 4090 | 165 | 329 | +100%(MMA 峰值速率) |
| README 特别说明:RTX 4090 会先撞上功耗墙,大矩阵在默认功耗下的实际收益远低于峰值。 |
2. README 官方数据:实际工作负载
| 场景 | 典型提升 |
|---|---|
| 大模型预填充 / 提示词处理(FP16/BF16 或 AWQ/GPTQ;vLLM、PyTorch、Transformers) | +25–55% |
| 首个 token 延迟 | 降低 25–30% |
| BF16 的 LoRA 与全量微调 | +25–50% |
| FP16/BF16 图像生成(ComfyUI 里的 SDXL、SD 1.5、Krea、DiT 类模型) | +30–55% |
| BF16 视频生成(Wan 2.2) | +15–20% |
| FlashAttention / SDPA 内核 | +50–60% |
| llama.cpp / Ollama 跑量化 GGUF | 0–15%,主要在长上下文 |
| 大模型逐字生成(受显存带宽限制) | 无变化 |
| INT8、FP8、INT4 模型 | 无变化 |
| 游戏与 FP32 CUDA | 无变化 |
| README 注明这些数字来自用户提交的兼容性报告。 | |
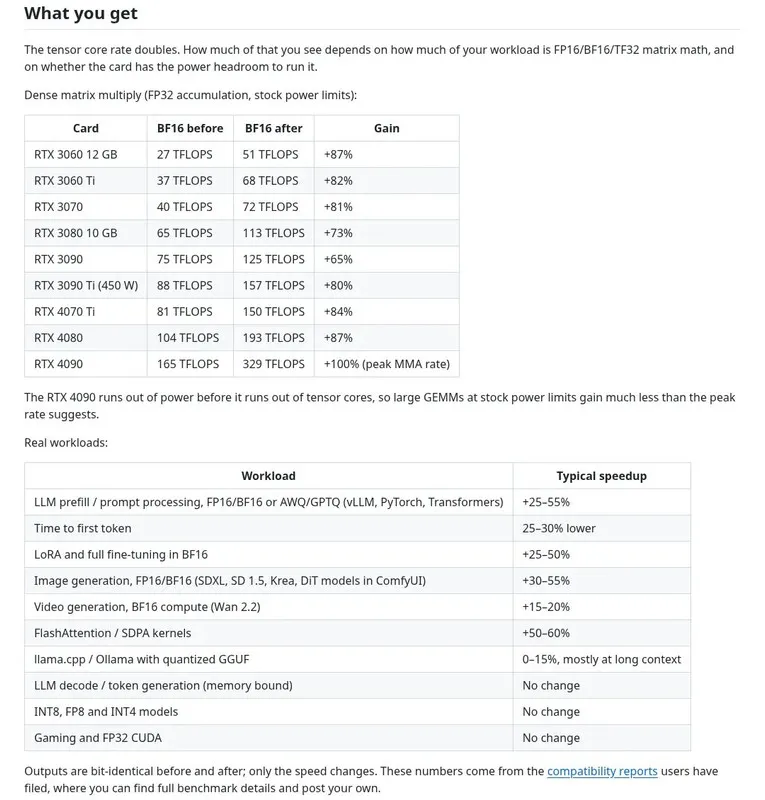 |
|
| 项目截图:README「What you get」里的矩阵乘法表和「Real workloads」表 |
3. 社区实测(第三方报告)
| 报告 | 平台 | 测试 | 解锁前 | 解锁后 |
|---|---|---|---|---|
| Zagitta/gpu-unlock Issue #143(RTX 3060 笔记本 6GB,GA106M) | Ubuntu,Linux 版 | 寄存器级 MMA,FP16/BF16→FP32 | 30.1 TF/s | 60.0 TF/s(约 2.0×) |
| 同上 | 同上 | cuBLAS GEMM 8192,BF16/FP32 | 29.23 TF/s | 50.17 TF/s(+72%) |
| 同上:对照组 | 同上 | FP16/FP16、INT8、FFMA | 59.5 / 120.3 / 14.3 | 59.6 / 120.1 / 14.4(不变) |
| Windows-GPU-UNLOCK 证据页(RTX 3060 12GB,GA104,B660 主板) | Windows 11,USB 启动路线 | PyTorch/cuBLAS n=4096,BF16 张量(FP32 累加) | 25.77 TFLOPS | 50.23 TFLOPS(1.95×) |
| 同上 | 同上 | TF32 张量 / FP32 非张量 | 12.98 / 7.99 | 25.24(1.94×)/ 8.03(不变) |
| 对照组没有变化,说明改动只作用于「半精度输入、FP32 累加」这条路径,和白皮书的说法吻合。但要注意,Windows 那份数据只来自一台特定主板加特定显卡的机器、两次启动,作者自己也写明了:长期稳定性、实际应用性能、重启和睡眠后的表现都「尚未确认」。 | ||||
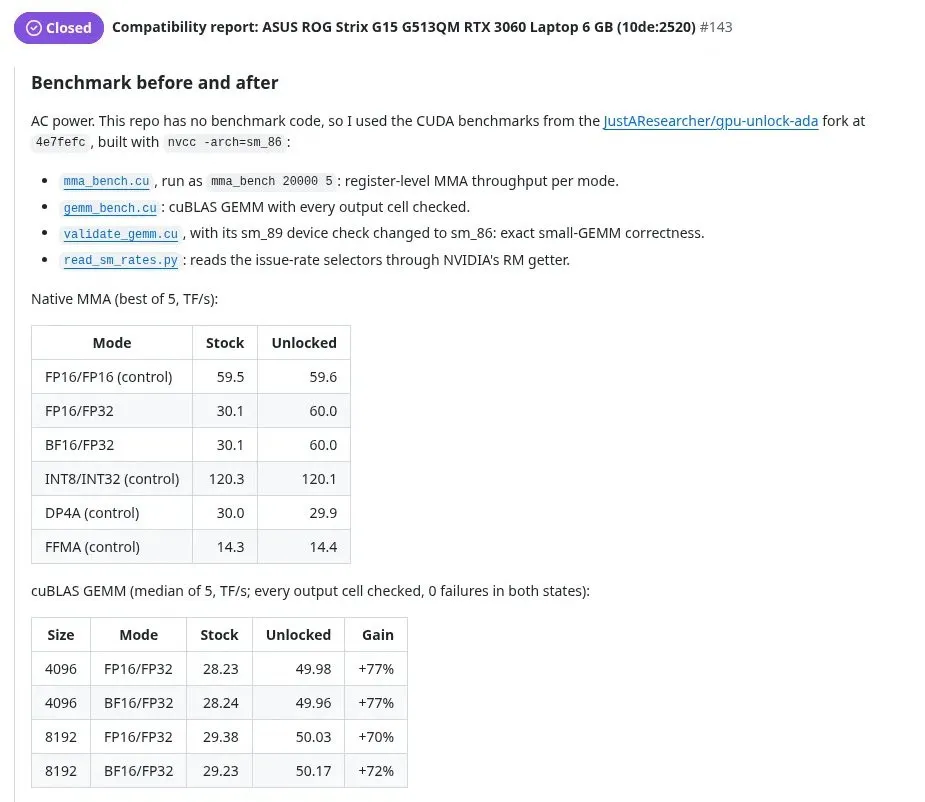 |
||||
| 社区截图:Zagitta/gpu-unlock Issue #143 兼容性报告里的前后对比(截图未包含报告者用户名与头像) | ||||
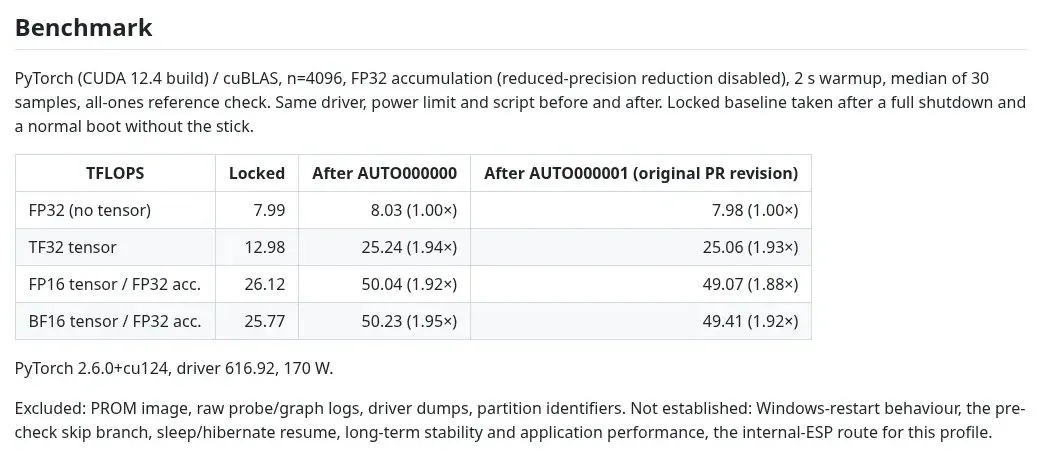 |
||||
| 项目截图:Windows-GPU-UNLOCK 仓库 evidence/b660plus-3060-usb 页面的锁定与解锁对比 |
4. 博主说法 vs 可核实来源
| 博主说法(视频/博客) | 可核实来源 | 判断 |
|---|---|---|
| 出厂「被人为锁了将近一半算力」 | 白皮书:仅 FP16/BF16→FP32 累加和 TF32 张量运算减半 | 夸大,被锁的只是部分张量运算 |
| FP16/BF16/TF32 张量吞吐最高翻倍;预填充 +25–55%;微调 +25–50%;图片/视频生成 +30–55% | README 原文 | 与 README 一致。注意 README 里的视频生成是 +15–20%,+30–55% 指的是图像生成 |
| 支持 20/30/40 系 | README:30 系稳定,40/20 系「实验性」,50 系不支持 | 基本属实,需注明「实验性」 |
| Windows 下目前只支持 30 系 | Windows 移植版支持表只列了特定 30 系卡加特定主板组合 | 属实,而且限制比「30 系」更窄 |
| 3060 实测「提升 50% 左右 / 差不多两倍」,Z-Image Turbo BF16 出图从约 26–36 秒(字幕不清)降到「十几秒」 | 博主自测,没有公开测试条件 | 未核实(原因见下一条) |
| 管理员 PowerShell 里执行「一键解锁命令」 | 那条命令是 python -I .\tools\collect_compatibility.py。README 写明它「只打印硬件和驱动信息,不会解锁、不改设置、不上传任何东西」,脚本第一行也写着「never run or authorize unlock」 | 不成立:这条命令不会解锁 |
| 3060 Ti 最高 +83% | README 表格:3060 Ti 矩阵乘法 +82% | 接近,但这是矩阵乘法峰值,不是出图速度 |
| 3050 8G +60% | README 表格里没有 3050 的数据 | 未核实 |
| 3080 Ti +50% | README 表格没有 3080 Ti;Windows 版对 3080/3080 Ti 只有「私下或研究性成功报告」 | 未核实 |
| 量化模型(Q4/Q6/Q8)没有加速 | README:量化 GGUF 0–15%,INT8/INT4 无变化 | 基本属实 |
| LocModel 是「免费的开源」模型工具 | LocModel 官网只写「免费」,没有声明软件本身开源 | 「开源」未核实 |
| 关于博主那组前后对比:既然视频里执行的命令本身不解锁,出图时间缩短就很可能另有原因。比如第一次生成通常包含模型加载和 CUDA 预热,第二次自然更快。这只是一种可能的解释,我没有复现,属于未核实。想自己测,请看第六节的验证方法。 |
四、支持哪些显卡和系统
Linux 主项目(Zagitta/gpu-unlock):
| 代际 | 显卡 | 状态 |
|---|---|---|
| Ampere(RTX 30) | 3050、3060、3060 Ti、3070、3070 Ti、3080、3080 Ti、3090、3090 Ti,以及 3070/3080 笔记本 | 稳定,100+ 用户报告 |
| Ada(RTX 40) | 4060 到 4090 D 各型号,以及 4050/4060 笔记本 | 实验性 |
| Turing(RTX 20) | 2060 到 2080 Ti、Titan RTX | 实验性 |
| Blackwell(RTX 50) | — | 不支持,作者说「不太可能支持」 |
| Windows 移植版:README 第一句就是「成功报告只适用于特定显卡加特定系统,不代表同型号的所有显卡」。目前列出的组合包括:RTX 3060 12GB(仅无头 USB 启动)、3060 Ti、3070(贡献者报告,实验性)、3070 Ti、3080 12GB(有 DP 输出恢复问题)、3090 FE、3090 Ti,每一项都绑定了具体的主板型号和启动路线。其他 3080/3080 Ti 只有私下或研究性报告。40 系在 Windows 上只有零散的第三方分支,不在这个仓库的支持范围内。 | ||
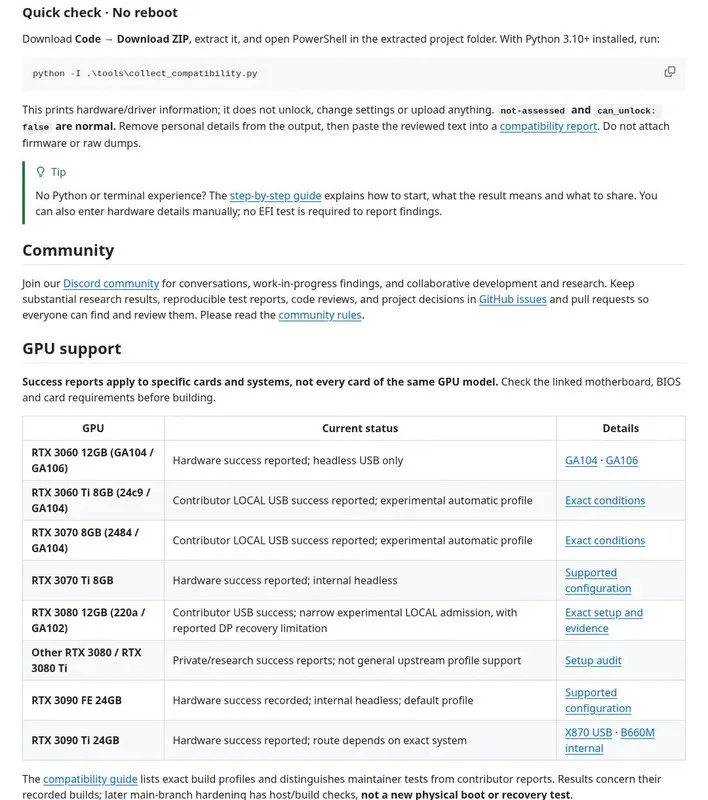 |
||
| 项目截图:Windows-GPU-UNLOCK README 的「Quick check • No reboot」,明确写着该命令 does not unlock(不会解锁);下方是 GPU 支持表 |
五、Windows 部署:真实流程是什么样
先打个预防针:按 README,Windows 上的解锁需要自己编译 UEFI 程序、准备固件文件、改启动项,复杂程度和「下载 zip、运行一条命令」差得很远。下面按官方 README 整理流程,以 README 默认的「B650M 主板 + RTX 3090 FE,内部无头启动」配置为例。其他配置的路线不同,一定以仓库里对应的指南为准。
-
对照配置清单:打开仓库的 docs/COMPATIBILITY.en.md 和 docs/CONFIRMED-SETUPS.en.md,确认你的显卡型号、PCI ID、主板型号和 BIOS 都在已报告的组合里。不在清单内的,不要硬上。
-
备份:完整备份重要数据,创建系统还原点,记下 BitLocker 恢复密钥。
-
下载源码:只从官方仓库 github.com/windows-GPU-UNLOCK/Windows-GPU-UNLOCK 用「Code → Download ZIP」下载并解压,不要用来路不明的网盘或安装器。
-
安装 Python 3.10+:安装时勾选「Add python.exe to PATH」,装完点「Disable path length limit」。这一步博主讲得没错。
-
先跑兼容性检查(不重启,也不解锁):在解压后的目录里打开 PowerShell,运行:
python -I .\tools\collect_compatibility.py
它只输出主板、CPU、系统、显卡型号和驱动版本。看到 not-assessed、can_unlock: false 是正常现象。可以把输出里的个人信息删掉后,提交到仓库的兼容性报告。到这一步,显卡还没有被解锁。
-
满足硬性前提(内部无头路线):关闭 Secure Boot;C 盘完全解密、关闭 BitLocker;接好键盘;保留原有的 Windows EFI 分区和恢复分区,另外准备一个至少 1 GiB 的 GPT FAT32 EFI 系统分区(工具不会帮你建分区)。USB 路线则需要一个 FAT32 U 盘,具体看 docs/HEADLESS-USB.en.md。
-
准备编译工具和固件:安装 clang/lld-link 20.1.8。按 docs/ASSETS.en.md,在 WSL 或 Linux 里用 Python 3.14 从主项目固定版本生成 5 个 NVIDIA 固件文件(仓库不附带,哈希值必须完全一致)。
-
配置、编译、注册测试启动项(管理员 PowerShell,在仓库根目录执行,GUID 和路径换成你自己的):
.\internal-boot\Configure.ps1 -UnlockDriveLetter U `
 -WindowsEspGuid 'YOUR-WINDOWS-ESP-GUID'
.\research\headless\build-unlock.ps1 `
 -Clang 'C:\TOOLS\LLVM20\bin\clang.exe' `
 -LldLink 'C:\TOOLS\LLVM20\bin\lld-link.exe'
.\internal-boot\Headless.ps1 -Assets '.\assets' -Register
这只是追加一个 F8 测试启动项,不改默认启动顺序。
9. 第一次测试:保存工作,完全关机,开机按 F8(README 测试用的是华硕主板),选「GPU Headless UNLOCK-EXPERIMENTAL」。等待期间不要按 T、U、回车。屏幕会黑一阵,随后进入 Windows。如果想放弃,前 5 秒内按 Esc 会跳过解锁,直接进入 Windows。
- 验证效果(见下一节)。只有测试成功后,才考虑设为默认自动启动:
.\internal-boot\Headless.ps1 -EnableAutomatic -ConfirmedSuccess
这一步会把解锁项排到 Windows 启动管理器前面,并关闭 Windows 快速启动。
11. 出问题怎么恢复:完全关机,按 F8 选「Windows Boot Manager」进入系统,然后运行 .\internal-boot\Headless.ps1 -RestoreWindowsFirst,恢复成 Windows 优先启动。
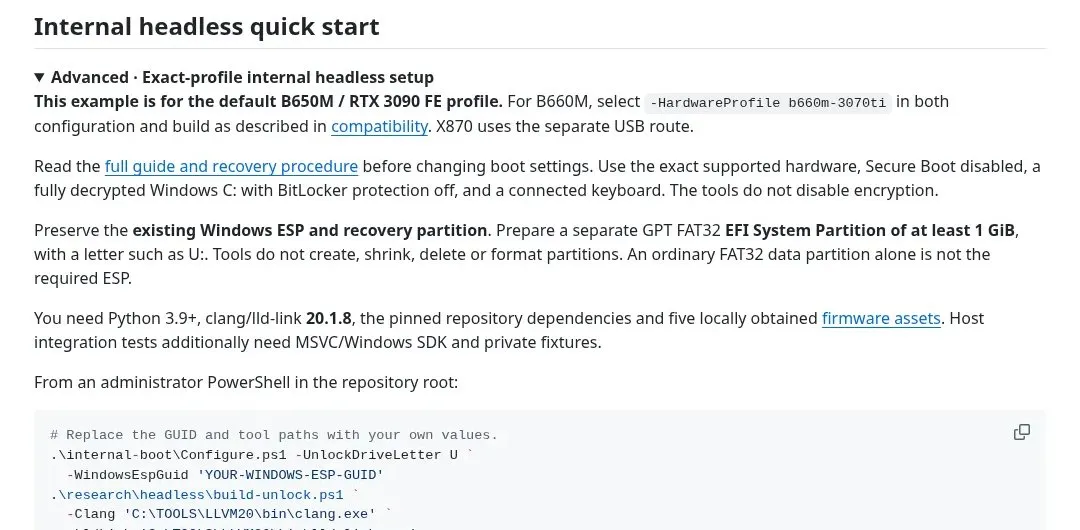
项目截图:README「Internal headless quick start」里的前置要求:关闭 Secure Boot、C 盘完全解密并关闭 BitLocker、连接键盘,并说明工具不会替你解除加密
Linux 用户的步骤简单得多(README 原文):
git clone https://github.com/Zagitta/gpu-unlock
cd gpu-unlock
make install
然后在内核启动参数里加上 gpu_unlock.targets=all(Ubuntu 等发行版编辑 /etc/default/grub 的 GRUB_CMDLINE_LINUX_DEFAULT,再执行 sudo update-grub),完全关机后冷启动即可。需要提前装好内核头文件和 DKMS。
关于 LocModel
博主用来测试的是 LocModel(官网 locmodel.com,字幕里识别成了「Local Model」)。官网目前显示:版本 v0.1.0,支持 Windows 10/11 x64,标注「免费」,基于 llama.cpp 推理引擎,支持 NVIDIA/AMD/Intel/CPU,可以从 Hugging Face 下载或导入 GGUF 模型,新增了 Z-Image Turbo 本地画图、Wan2.2 视频生成和 Agent 功能。官网没有写明开发者或公司,也没有声明软件本身开源。
需要提醒的是:README 的数据显示,llama.cpp 跑量化 GGUF 只有 0–15% 的提升,逐字生成没有变化。LocModel 的画图功能用什么后端、能不能吃到这部分加速,未核实。想明确验证效果,用 PyTorch 或 ComfyUI 跑 BF16/FP16 模型更直观。
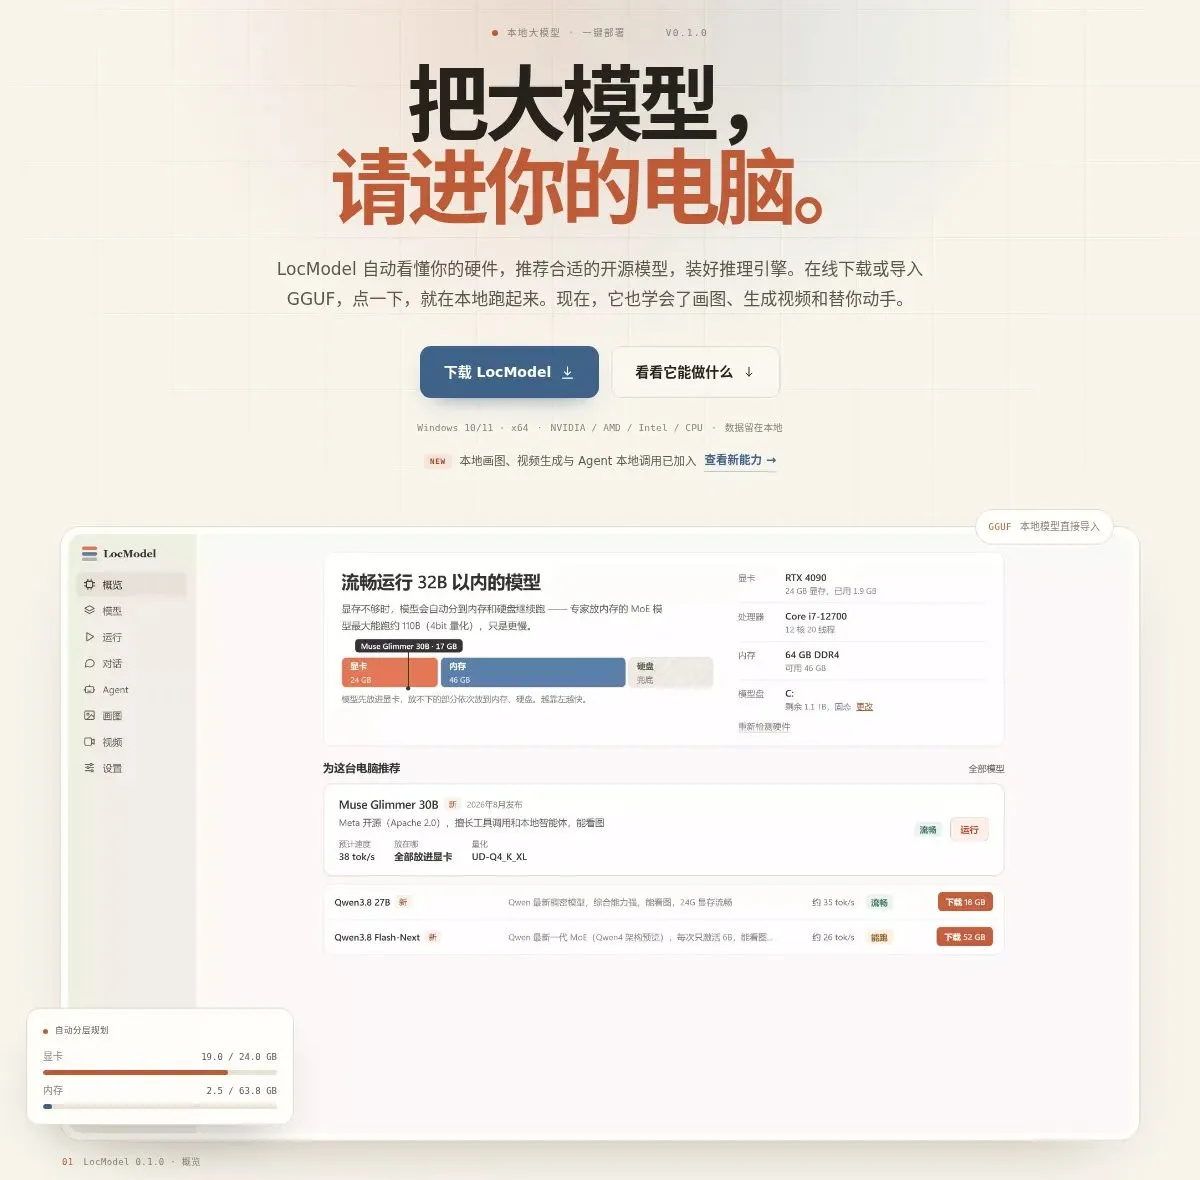
官方截图:LocModel 官网首页(locmodel.com,2026-11-03 截取)
六、怎么验证到底有没有生效
别拿「第一张图 vs 第二张图」的出图时间来判断。比较靠谱的做法有这几种:
· Linux:执行 journalctl -k -b | grep gpu_unlock,查看模块日志。
· Windows:用仓库自带的基准工具,见 docs/BENCHMARK.en.md。
· 通用的简易自测:下面是我写的一个 PyTorch 小脚本,思路参考 README 和社区报告的测试方法。它不是项目官方工具,我也没有在实机上运行过:
import torch, time
torch.backends.cuda.matmul.allow_fp16_reduced_precision_reduction = False
torch.backends.cuda.matmul.allow_bf16_reduced_precision_reduction = False
n, iters = 4096, 50
for dt in (torch.float16, torch.bfloat16, torch.float32):
 a = torch.randn(n, n, device="cuda", dtype=dt)
 b = torch.randn(n, n, device="cuda", dtype=dt)
 for _ in range(10): a @ b # 预热
 torch.cuda.synchronize(); t = time.time()
 for _ in range(iters): a @ b
 torch.cuda.synchronize()
 print(dt, round(2 * n**3 * iters / (time.time() - t) / 1e12, 1), "TFLOPS")
判断方法:解锁前后各跑几次取中位数,其他条件保持不变(同一驱动、同一功耗上限)。FP16/BF16 接近翻倍、FP32 基本不变,就说明生效了。拿 RTX 3060 12GB 作参考,社区报告的 BF16 是约 26 → 约 50 TFLOPS。测 AI 出图时,固定模型、分辨率、步数和种子,先预热一张,再取多张的平均值。
七、风险与注意事项(务必看完)
⚠ Windows 版要关闭 Secure Boot 和 BitLocker:系统的启动防护和全盘加密会失效。不少游戏的反作弊要求开启安全启动,例如 EA 官方说明《战地 6》在 PC 上必须开启 Secure Boot,Valorant 在 Windows 11 上也要求开启,FACEIT 同样有此要求。关掉之后,这些游戏就进不去了。
⚠ 改启动链有翻车风险:屏幕会黑一段时间。配置不对可能进不了系统,或者显示输出恢复不了(README 提到 3080 12GB 有 DP 恢复问题)。分区操作失误还可能丢数据。动手前先把恢复流程读一遍。
· 实验性质:Windows 版是「仅源码预发布」,成功记录绑定在特定机器和特定构建上,后续代码改动并不等于又做过一次实机测试。40 系和 20 系在 Linux 上也是实验性的。
· 涉及固件层面的利用:解锁要借用 NVIDIA 固件在驱动加载前改写寄存器,Hacker News 上的测试者形容它「依赖对固件的利用,有一点风险」。这不是 NVIDIA 官方支持的功能。
· 保修:NVIDIA 和显卡厂商的保修条款是否会因此受影响,未核实。保守起见,按「可能影响保修」看待。
· 发热和功耗:主项目 FAQ 说损伤显卡「非常不可能」,但计算量增加后显卡会更热,原有的降频和功耗保护仍然有效。
· 数值精度:README 写明输出逐位一致,仍是 FP32 累加,精度不受影响。
· 假安装器和来路不明的网盘:只用官方 GitHub 仓库。主项目作者专门提醒过要警惕流传的 Windows 安装器,博客里的「备用下载」网盘链接,本文不推荐。
· 会自动失效:断电、睡眠、笔记本独显空闲断电都可能让解锁复位。
· 视频里的其他内容:视频后半段还推荐了「越狱 / 无审查」模型,本文不推荐,也不提供相关内容。
八、常见问题
Q:解锁后玩游戏会更快吗?
不会。README 写明游戏和 FP32 CUDA「无变化」。
Q:我用 Ollama 或 LM Studio 跑 Q4 量化模型,有用吗?
作用很小。量化 GGUF 只有 0–15% 的提升,主要出现在长上下文;逐字生成受显存带宽限制,没有变化。
Q:RTX 50 系能用吗?
不能,主项目作者说「不支持,也不太可能支持」。
Q:照着视频跑完那条 PowerShell 命令,是不是就解锁了?
不是。collect_compatibility.py 只是收集硬件信息的检测脚本,README 和脚本源码都写明它不会解锁。
Q:NVIDIA 更新驱动后要重新弄吗?
Linux 版不用,它不修改驱动。Windows 版在每次开机、Windows 启动前运行,文档里的测试显示驱动保持不变。不过 Windows 版的测试记录很有限。
Q:为什么 NVIDIA 要限速?
主项目 FAQ 的说法是市场分级。专业卡(RTX A 系列等)在同样的芯片上没有这项限制,价格高得多。
Q:笔记本能用吗?
Linux 版支持部分笔记本显卡,但独显一断电解锁就会失效,效果不稳定。Windows 版目前没有笔记本配置。
九、总结
· 限制是真的:GeForce 上「FP16/BF16 输入 + FP32 累加」和 TF32 的张量吞吐只有同芯片专业卡的一半,NVIDIA 白皮书白纸黑字写着,用途是产品分级。
· 提升也是真的,但有范围:矩阵乘法接近翻倍,跑 BF16/FP16 模型的出图、预填充、微调有 25–55% 左右的提升。逐字生成、量化模型和游戏基本不受益。
· Windows 没有一键解锁:视频里的「一键命令」只是检测脚本。真正的 Windows 解锁要自己编译 UEFI 程序、关闭 Secure Boot 和 BitLocker、改启动项,而且只在少数特定组合上测试成功过。
· 建议:如果你的显卡是 30 系、主要跑 BF16/FP16 的 PyTorch 或 ComfyUI 工作流,又愿意折腾,Linux 版更成熟。Windows 用户先跑兼容性检查,确认自己的组合在清单里,再决定要不要冒这个风险。只用 Q4 量化模型聊天的话,没必要折腾。
信息来源与截图来源
核实日期:2026 年 11 月 3 日。
原始素材
· 零度解说 YouTube 视频(2026-11-03):https://www.youtube.com/watch?v=ao6B7GR8tQY 。本文未下载视频,文中没有视频截图;博主说法依据视频字幕和视频说明整理。
· 零度博客配套文章:https://www.freedidi.com/25903.html
项目与官方资料
· 主项目 Zagitta/gpu-unlock(README、FAQ、How it works):https://github.com/Zagitta/gpu-unlock
· Windows 移植版(原 impacifist/Windows-GPU-UNLOCK,现地址):https://github.com/windows-GPU-UNLOCK/Windows-GPU-UNLOCK
· Windows 版固件准备说明:https://github.com/windows-GPU-UNLOCK/Windows-GPU-UNLOCK/blob/main/docs/ASSETS.en.md
· 兼容性检测脚本源码:https://github.com/windows-GPU-UNLOCK/Windows-GPU-UNLOCK/blob/main/tools/collect_compatibility.py
· NVIDIA Ampere GA102 架构白皮书:https://www.nvidia.com/content/PDF/nvidia-ampere-ga-102-gpu-architecture-whitepaper-v2.pdf
· NVIDIA Ada 架构白皮书:https://images.nvidia.com/aem-dam/Solutions/geforce/ada/nvidia-ada-gpu-architecture.pdf
· LocModel 官网:https://locmodel.com/
· EA《战地 6》Secure Boot 说明:https://www.ea.com/games/battlefield/battlefield-6/news/secure-boot-information
社区资料
· Zagitta/gpu-unlock Issue #143(RTX 3060 笔记本兼容性报告):https://github.com/Zagitta/gpu-unlock/issues/143
· Windows 版 RTX 3060 12GB 证据页:https://github.com/windows-GPU-UNLOCK/Windows-GPU-UNLOCK/blob/main/evidence/b660plus-3060-usb/README.md
· Hacker News 讨论(作者与测试者留言):https://www.betterhackernews.com/item/50219700
截图来源
| 截图内容 | 类型 | 来源 |
|---|---|---|
| 封面 | AI 生成背景 + 文字排版 | 背景由 AI 生成,不代表任何真实界面 |
| gpu-unlock README 顶部、FAQ、基准表 | 项目截图 | github.com/Zagitta/gpu-unlock |
| Windows 版 Quick check 与支持表、前置要求、RTX 3060 证据页 | 项目截图 | github.com/windows-GPU-UNLOCK/Windows-GPU-UNLOCK |
| LocModel 首页与功能区 | 官方截图 | locmodel.com |
| RTX 3090 / RTX A6000 / RTX 4090 规格表 | 官方截图 | NVIDIA 白皮书 PDF 页面渲染后裁剪(RTX 4090 表由第 29、30 页拼接) |
| RTX 3060 笔记本兼容性报告 | 社区截图 | GitHub Issue #143,截图未包含报告者用户名与头像 |
| 所有网页截图均于 2026-11-03 通过浏览器截取。 | ||
| 本文仅供技术学习交流。显卡解锁属于非官方、实验性操作,请在充分了解风险后,自行决定是否在个人设备上测试。 |
原文首发于 AI 世界进展(cutting-edgetechnology-ai.blogspot.com):https://cutting-edgetechnology-ai.blogspot.com/2026/11/n-ai-gpu-unlock-windows.html